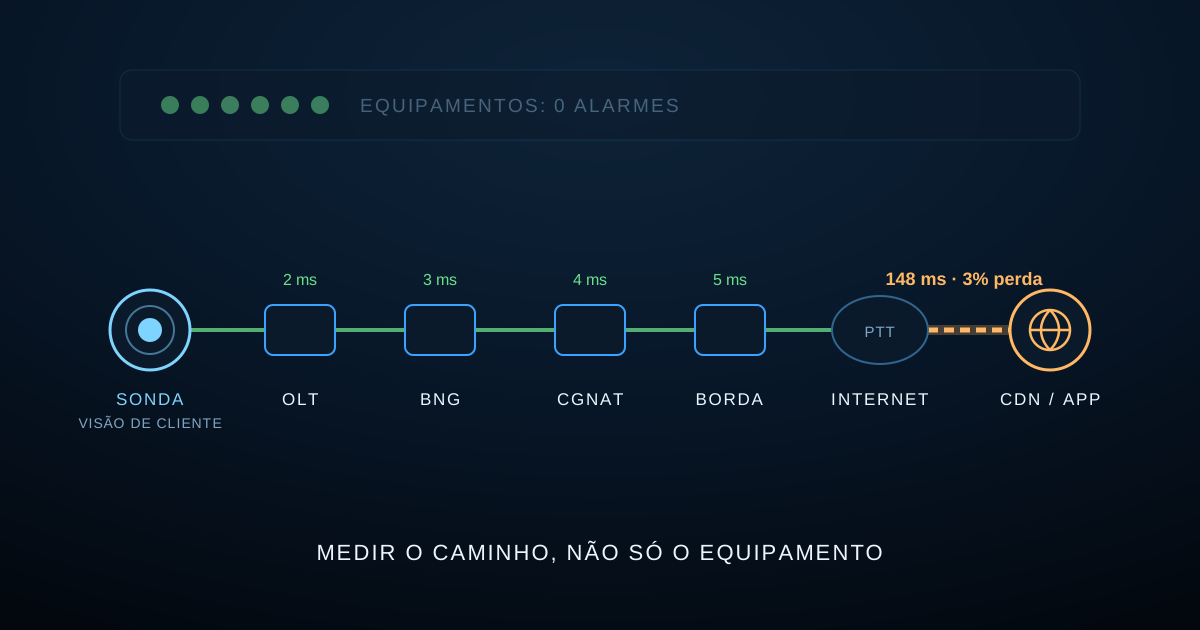
Todo NOC de provedor já viveu a cena: o painel inteiro verde, nenhuma trigger ativa, e o atendimento recebendo uma fila de "a internet tá lenta", "o jogo tá travando", "não abre o banco". No fim, a causa estava num lugar que nenhum item monitorava — o DNS respondendo devagar, uma rota pro CDN indo pelo caminho errado, perda de pacote só em um trânsito.
O problema não é falta de monitoramento. É que quase tudo é monitorado de dentro pra fora: o estado de cada equipamento. E o cliente não usa equipamentos — usa um caminho.
O que é "outside-in" e por que voltou à pauta
Entre as tendências de observabilidade de rede pra 2026 que a Broadcom destacou, uma das centrais é justamente a visibilidade outside-in: medir o caminho completo, salto a salto, incluindo pontos de troca de tráfego e a entrada nos provedores de nuvem — e não só o que está atrás do próprio firewall. O argumento é que infraestrutura saudável não garante usuário satisfeito.
O texto foi escrito pensando em empresa olhando pra internet. Mas pro provedor, a lógica é ainda mais direta: você é o caminho. Se o cliente não chega bem no Google, no WhatsApp ou no banco, pra ele a culpa é sua — esteja o problema na sua rede ou não.
E tem um ganho operacional claro, que o mercado chama de mean time to innocence: quanto mais rápido o NOC prova que o problema está fora (no CDN, no upstream, no serviço do terceiro), mais rápido o atendimento consegue responder o cliente com algo melhor que "estamos verificando".
O que medir
A ideia é simular, de forma contínua e automática, o que o cliente faz:
- Resolução DNS dos domínios mais acessados, medindo tempo de resposta do recursivo do provedor — não só se ele está "up".
- Latência e perda até destinos reais: grandes CDNs, nuvens públicas, o PTT mais próximo, serviços de jogo e de pagamento populares na sua região.
- Requisição HTTP/HTTPS completa a alguns sites de referência: tempo total, código de resposta, tempo até o primeiro byte.
- Caminho (traceroute) periódico pros destinos críticos, guardando o resultado — quando a latência subir, você quer saber se a rota mudou.
Como fazer com Zabbix, sem ferramenta nova
O Zabbix já tem as peças; o que muda é de onde elas rodam:
- Sonda com visão de cliente. Um Zabbix proxy leve, com agente junto, num hardware pequeno instalado numa conexão que passa pelo mesmo caminho de um assinante comum: atrás de uma ONU, autenticado no concentrador, saindo pelo CGNAT. Medir a partir do servidor de monitoramento, dentro do datacenter, pula metade do caminho. O proxy importa porque ping e web scenario rodam em quem faz a coleta — se a coleta é no datacenter, a medição também é.
- Uma sonda por região importante. Se você tem POPs em cidades diferentes, a experiência é diferente em cada uma. Comparar sondas é o que separa "problema geral" de "problema naquele POP".
- Itens nativos:
net.dns.perf(no agente) pra tempo de DNS,icmppingseceicmppingloss(no proxy) pra latência e perda, web scenarios pra transações HTTP com tempo por etapa. - Triggers de experiência, com limiar pensado no que o cliente sente: DNS acima de 100 ms, perda acima de 1% pra um CDN, página de referência acima de alguns segundos.
- Correlação com a rede. A sonda alarma; a pergunta seguinte é "o que mudou na rede ao mesmo tempo?". Tráfego no trânsito, estado das sessões BGP, CPU do concentrador — tudo no mesmo painel, na mesma linha do tempo.
O que muda na operação
Com sondas de cliente rodando, o NOC passa a ter um indicador que nenhum equipamento entrega sozinho: "como está a internet do meu assinante agora, em cada cidade". É o número que o atendimento queria ter na tela quando o telefone toca — e o que mostra, com dado, quando o problema não é seu.
Se quiser ver como uma visão por região ajuda a separar problema local de problema geral, dá uma olhada em como funciona o NOC Geomap — ou fale com a gente pra montar as primeiras sondas.
Fonte: Broadcom — Top 3 Trends Defining Network Observability in 2026.