Em pouco mais de um mês, o mercado de AIOps mudou de vocabulário. Em setembro, a Selector lançou o Foundry, um ambiente pra equipes de rede construírem e governarem os próprios agentes de IA. Em 19 de outubro, a Innovorbs anunciou um "NOC autônomo" como serviço gerenciado, com agentes que detectam, diagnosticam e executam a correção. Em 23 de outubro, a NVIDIA apresentou o Minerva, plataforma que junta telemetria de GPU, rede e storage num grafo pra antecipar falha em data center de IA.
O ponto comum não é "IA no NOC" — isso já era conversa. É o agente com permissão pra agir. E aí a pergunta muda de "ele acerta?" pra "como eu sei que ele acerta antes de deixar ele mexer no BGP às 3h da manhã?".
A ideia que vale copiar: replay contra o seu passado
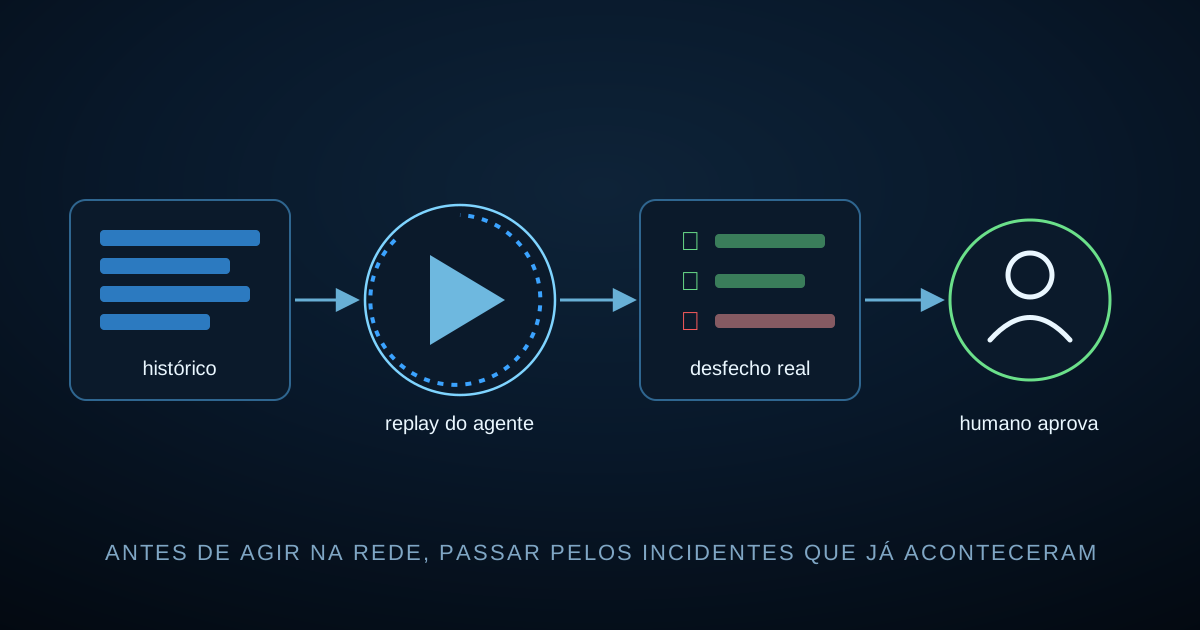
A proposta mais interessante desses lançamentos é a da Selector: antes de um agente ir pra produção, ele é rodado contra incidentes passados do próprio cliente e comparado com o que de fato aconteceu em cada um. Passou, é promovido; falhou, volta com um passo. O agente fica versionado num repositório Git e passa por revisão como qualquer mudança.
Independente de fornecedor, esse é o método certo. Provedor tem um banco de testes que nenhum laboratório reproduz: o próprio histórico. Rompimento de fibra que derrubou 4 PONs, flap de BGP com operadora de trânsito, queda de energia no POP, DDoS de madrugada. Cada um desses tem início, sintomas, causa e o que foi feito pra resolver — se estiver registrado.
Como montar isso mesmo sem plataforma nova
- Escolha 20 a 30 incidentes reais dos últimos meses, variados: fibra, energia, equipamento, tráfego, falso positivo.
- Registre o desfecho de cada um: causa raiz confirmada, ação que resolveu, tempo até resolver. Sem isso não há com o que comparar.
- Rode a automação (ou o assistente) em modo "só sugere" contra os eventos daquele período e compare: a causa apontada bate? A ação proposta é a que funcionou? Teria piorado alguma coisa?
- Conte os erros perigosos à parte. Errar a causa é ruim; sugerir reiniciar a OLT errada é outra categoria.
- Repita a cada mudança no agente ou na regra — é teste de regressão, não validação de uma vez só.
O que o agente pode tocar (e o que não pode)
A Innovorbs descreve um modelo que vale de referência: cada playbook é aprovado pelo cliente antes de ser ativado, ações de alto impacto pausam pra aprovação humana e tudo o que o agente faz fica visível, com o raciocínio. Traduzindo pra provedor:
- Liberado pra executar sozinho: coisas reversíveis e locais — reabrir sessão, limpar contador, coletar diagnóstico, abrir chamado com contexto.
- Sempre com humano aprovando: qualquer coisa que afete muitos clientes de uma vez — reinício de OLT, mudança de rota, failover de link de trânsito.
- Fora de alcance: credenciais, configuração de segurança, regras de firewall de borda.
Nenhum dos três anúncios publicou número de MTTR medido; são promessas de fornecedor. Isso reforça o ponto: a prova tem que ser feita com os seus dados, não com o slide de lançamento.
O pré-requisito que ninguém anuncia
Replay só funciona se o histórico existe e é confiável: evento com horário correto, alarme ligado ao equipamento e à localização certos, incidente fechado com a causa real. Se hoje o seu NOC resolve e esquece, o primeiro passo rumo à automação é registrar bem. Se quiser conversar sobre como estruturar isso, fale com a gente.
Fontes: Network World — Selector Foundry, EIN Presswire — Innovorbs Autonomous NOC, Developer-Tech — NVIDIA Minerva.